スタンバイへ求人情報を連携する方法の一つが、XMLフィードによる入稿です。求人情報をXML形式で構造化してスタンバイに渡すことで、求人を効率よく掲載・更新できます。
ただし、注意したいのは、単に求人ページの情報をそのままXMLにすればいいわけではない、という点です。スタンバイのXMLフィードには、たとえば次のようなルールがあります。
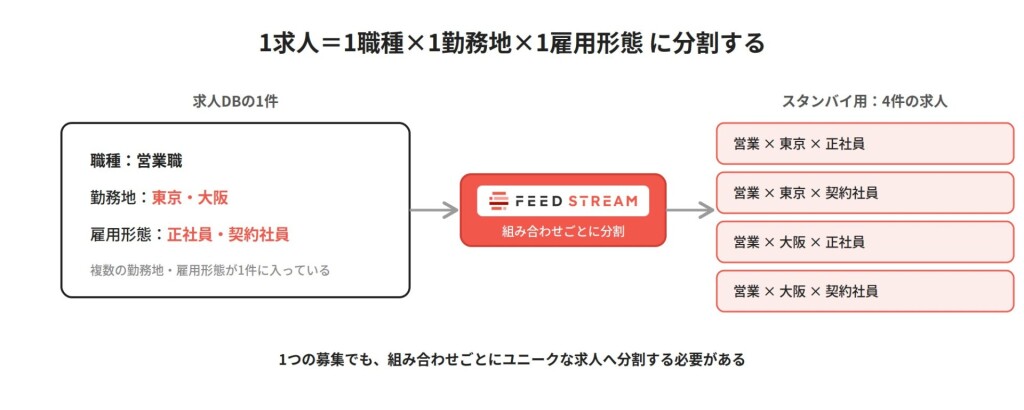
- 1求人=1職種×1勤務地×1雇用形態で作成する
- 必須項目がかなり細かく設定されている
- 給与はスタンバイが解析・構造化できる形式で記載する
- 求人URLは一意である必要がある
- HTMLタグは含めない
- 原則としてリダイレクトURLを使わない
- 募集終了求人を含めない
つまり、自社の求人データを「スタンバイが理解できるデータ構造」へ整えることが求められます。本記事では、スタンバイの求人データフィード(XMLフィード)の仕組みから、主要な項目、作成・連携時の注意点まで、2026年時点の仕様をもとに解説します。
なお本記事は公開情報と公式の入稿マニュアルをもとにしていますが、スタンバイの仕様は更新されることがあります。実際の入稿時には、スタンバイ公式の求人掲載マニュアルで最新の仕様を必ずご確認ください。
1. スタンバイの求人データフィードとは?
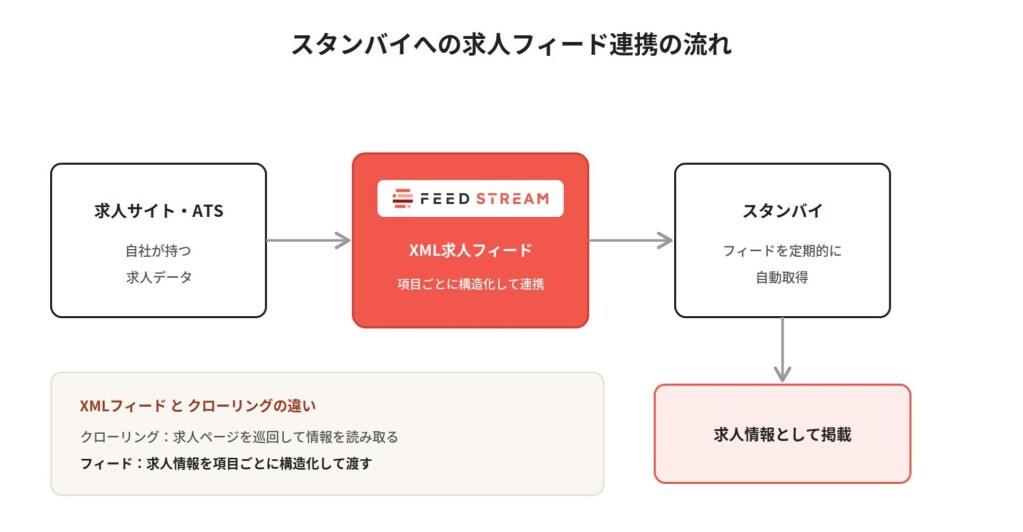
スタンバイの求人データフィードとは、自社が持つ求人情報を、スタンバイの仕様に合わせてXML形式で連携する仕組みです。全体像は次のようになります。
求人サイト・採用管理システム(ATS)→ XML求人フィード → スタンバイ → 求人情報として掲載
スタンバイの入稿方法には、XMLフィードのほかにクローリング(スタンバイが自社の求人ページを巡回して情報を取得する方式)もあります。両者の違いを簡単に整理すると、クローリングが「ページを読み取ってもらう」のに対し、XMLフィードは「求人情報を項目ごとに構造化して渡す」方式です。
XMLフィードの利点は、求人情報を項目単位で正確に渡せること。求人件数が多かったり、給与・勤務地・募集状況などの更新頻度が高かったりするサイトでは、データ連携をシステム化しやすくなります。
ひとつ補足しておくと、「フィードの方が掲載順位に有利」といった話を見かけることがありますが、これは公式に示された根拠があるわけではありません。本記事では、あくまで「構造化されたデータを正確に連携できる」という観点で解説します。
2. スタンバイのXMLフィードの基本仕様
まず、技術的な基本仕様を押さえましょう。
| 項目 | 仕様 |
|---|---|
| データ形式 | XML(.xml)またはGZIP圧縮XML(.gz) |
| 文字コード | UTF-8 / EUC-JP / Shift_JIS |
| XML宣言 | 先頭行に必要 |
| データ記述 | 各項目の値をCDATA内に記述 |
| 求人単位 | 1要素につき1求人 |
| ファイル名 | 半角英数字・ハイフン・アンダースコア |
| ファイル容量 | 解凍後1.5GB以内 |
| 更新 | スタンバイが定期的にチェックして自動取得 |
.xlsxや.zipは対応していません。また、対象サイトが複数ある場合も、原則として1サイト1ファイルで用意します。
XMLの構造は、イメージとしては次のような形です。
<?xml version="1.0" encoding="UTF-8"?>
<source>
  <job>
    <url><![CDATA[https://example.com/jobs/12345]]></url>
    <referencenumber><![CDATA[12345]]></referencenumber>
    <title><![CDATA[法人営業]]></title>
    <company><![CDATA[株式会社〇〇]]></company>
    <!-- 以下、各項目が続く -->
  </job>
</source>
<source>の中に求人ごとの<job>要素が並び、各項目の値はCDATAセクション内に記述します。CDATAを利用することで、&や<などXML上で特別な意味を持つ文字を、通常の文字列として扱いやすくなります。なお、スタンバイでは求人原稿内にHTMLタグを含めないよう定められているため、CDATA内であってもHTMLタグは使用しないようにしましょう。


3. スタンバイの求人フィードで使用する主な項目
スタンバイ用のデータは項目数が多いので、まずは主要な必須項目を一覧で整理します。
必須項目
| 要素名 | 内容 |
|---|---|
| url | 求人詳細ページのURL |
| referencenumber | 求人を一意に識別するID |
| title | 職種など求人内容を特定するタイトル |
| company | 雇用主となる企業名 |
| state | 勤務地の都道府県 |
| city | 市区町村以下の勤務地 |
| description | 仕事内容 |
| salary | 給与区分・金額 |
| jobtype | 雇用形態 |
| benefits | 待遇・福利厚生 |
| insurance | 加入保険 |
| preventsmoke | 受動喫煙防止措置 |
| timeshift | 勤務時間 |
| holiday | 休日 |
| contractperiod | 契約期間 |
必須項目が多く、特にbenefits・insurance・preventsmoke・timeshift・holiday・contractperiodといった待遇・勤務条件まわりまで必須に含まれるのが、スタンバイのフィードの特徴です。
条件付き必須の項目
状況に応じて必須になる項目もあります。
| 要素名 | 内容 | 必須になる条件 |
|---|---|---|
| agency | 人材紹介会社名 | 人材紹介会社が掲載する場合 |
| station | 勤務地の駅情報 | cityに詳細住所がない場合 |
任意項目
このほか、求人をよりリッチにするための任意項目があります。store(店舗・事業所)、trafficaccess(交通アクセス)、education(学歴)、experience(経験)、trialperiod(試用期間)、companyaddress(企業住所)、businesscontents(事業内容)、jobinformation(募集情報)、expdate(掲載終了日)、category(職種カテゴリ)、imageurls(画像)、applyurl(応募URL)などです。任意項目も、埋めるほど求人情報が充実し、求職者が比較・検討しやすくなります。
ここからは、特に注意が必要な項目を個別に掘り下げます。
4. 求人タイトル(title)の仕様と注意点
titleは、求職者が最初に目にする最も重要な項目です。スタンバイ公式では、職種を必ず記載したうえで、「職種を文頭に置く」「35文字以内」を強く推奨しています。
ポイントは、「何の仕事か」が一目で分かる構造にすることです。
| タイトルの例 | |
|---|---|
| △ 訴求が先に来る | 未経験OK!年間休日120日以上!急成長企業で働く法人営業 |
| ○ 職種が文頭に来る | 法人営業|未経験OK・年間休日120日以上 |
前者は魅力的な言葉が並んでいますが、肝心の「法人営業」が文末まで出てきません。後者のように、まず職種を置き、補足情報を後ろに回す構造にすると、求職者にとっても、求人を職種で構造化するスタンバイにとっても分かりやすくなります。
これは、求人フィードを最適化していくうえでの基本的な考え方でもあります。限られた文字数の中で、検索されやすく・理解されやすいタイトルをどう作るかが、求人の見つけられやすさに関わってきます。
5. 給与(salary)は「解析できる書き方」が重要
この記事で特に重要なのが、給与(salary)の書き方です。
スタンバイは、salaryに記述されたテキストから給与情報を解析・構造化します。公式仕様では、(給与区分)+(金額)+円 という構造が基本とされています。
解析可能な例
- 年収4500000円
- 年収500万円(年俸制)
- 月給 200,000~300,000円
- 月給 30万円 ※みなし残業代含む
- 日給8,000円~10,000円
解析できない例
- 400000円
- 月給400000
給与区分・金額・単位が揃って初めて、機械は正しく解析できます。
さらに公式では、モデル年収や各種手当など、余計な給与情報を混ぜると誤解析につながる可能性があるため、可能な限り含めないよう案内されています。
データフィードは、情報量が多ければいいわけではなく、機械が構造化できる表現であることが重要なのです。求職者向けに手当やモデル年収を細かく書き込むほど、かえって解析を誤らせることがある。この「ユーザーが読む文章」と「機械が解析するデータ」の違いを意識することが、フィード運用では欠かせません。
6. 勤務地(state / city / station)の仕様
勤務地まわりも、独自のルールがあります。
state(都道府県)とcity(市区町村以下)は、基本的に必須です。在宅勤務の求人の場合は、次のように記述します。
<state><![CDATA[在宅]]></state>
<city><![CDATA[在宅]]></city>
注意したいのがstation(駅情報)です。stationは、cityに詳細住所がない場合は必須になります。公式仕様では、詳細住所とstationの両方がないと、検索結果に求人が表示されないと明記されています。
ここからも分かるように、勤務地情報は単に「求職者に見せる住所」ではなく、スタンバイが求人を勤務地別に構造化し、エリア検索に正しくヒットさせるためのデータです。だからこそ、都道府県・市区町村・駅のいずれかで、求人の場所が確実に特定できる状態にしておく必要があります。
7. 雇用形態(jobtype)には指定できる値がある
スタンバイのフィードで有効な雇用形態の値は、次の6種類に決められています。
正社員 / 契約社員 / 派遣社員 / パート / アルバイト / 業務委託
ここで注意が必要なのが自社の求人DBに入っている値です。たとえば、
- 正規社員
- パートタイマー
- 派遣
- アルバイトスタッフ
このような独自の表記が入っている場合、そのまま連携しても正しく扱われません。スタンバイでは有効な表記が指定されているため、自社DBで独自の雇用形態名を使用している場合は、スタンバイの規定値へ変換して連携する必要があります。(正規社員→正社員、派遣→派遣社員、など)。
8. 「1求人=1職種×1勤務地×1雇用形態」が重要
スタンバイでは、1求人は1職種×1勤務地×1雇用形態と明記されています。
たとえば、自社の求人DBに次のような1件の求人があったとします。
- 職種:営業職
- 勤務地:東京・大阪
- 雇用形態:正社員・契約社員
これを1レコードのまま連携することはできません。次のように、職種×勤務地×雇用形態の組み合わせごとに、ユニークな求人へ展開する必要があります。
- 営業 × 東京 × 正社員
- 営業 × 東京 × 契約社員
- 営業 × 大阪 × 正社員
- 営業 × 大阪 × 契約社員
9. 求人URL(url)と求人ID(referencenumber)の設計
urlとreferencenumberは、どちらも「求人を一意に特定する」ための項目ですが、役割が異なります。
url(求人詳細ページのURL)
- 求人詳細ページを指すこと
- 一意であること
- http / httpsを含むこと
- リダイレクトしないURLであること
- 同一求人のURLを毎日のように変えないこと
- UTMなどのクエリパラメータは設定可能
- 日本語パラメータは非対応
referencenumber(求人ID)
- 求人そのものを一意に識別するID
urlにはクエリパラメータを付けられるので、流入計測のために次のような指定ができます。
https://example.com/jobs/12345?utm_source=stanby
同一求人の求人詳細ページURLは、毎日のように頻繁に変更しないよう公式から案内されています。urlとreferencenumberを安定して管理し、同じ求人には継続して同じ値を使用できる設計にしておくとよいでしょう。
10. 画像(imageurls)を連携する場合の仕様
画像を連携する場合も、細かい仕様があります。現在の主な要件は次のとおりです。
- 1求人あたり6枚まで
- 形式はJPEG / PNG
- 最大8MB
- 横600px以上
- 縦400px以上
- 推奨比率3:2
- HTTPSのURLのみ
- 求人ページ上に実際に掲載されている画像を使う
実装上の注意として、画像を確実に更新したい場合はURLを変更する、というルールがあります。同じURLのまま中身だけ差し替えると、更新が反映されにくいためです。
11.必須項目の情報が元データにない場合は?
スタンバイでは必須項目が含まれない求人は掲載できません。一方、求人DB側に待遇・保険・受動喫煙防止措置などの情報が独立した項目として存在しないケースもあります。
その場合、一部の必須項目では、別のカラムに情報が記載されていれば「○○欄をご参照ください」と記載する方法や、情報取得が難しい場合に所定の文言を記載する方法が公式仕様で案内されています。
つまり、求人フィードを生成する際には「元データに値がない=空欄で出力する」のではなく、媒体ごとの必須条件に合わせた補完ルールまで設計する必要があります。
12. スタンバイに連携してはいけない求人
現在の公式仕様では、次のような求人をフィードに含めないよう案内されています。
- 他求人サイトの求人
- ログインしないと閲覧できない求人
- 募集終了求人
- 求人ページに存在しない内容を追加した求人
- テスト求人・存在しない求人
- 応募可能なランディングページがない求人
また、ハローワークからの転載求人を含む場合などは、フィードの取り込み自体が事前通知なく停止される場合もあるとされています。
これらは「審査を通すためのテクニック」ではなく、求職者が実際に応募できる、正確な求人だけを掲載するための運用ルールと捉えるのが適切です。募集が終わった求人や、応募できない求人が残っていると、求職者の体験を損ない、媒体からの信頼も失います。フィードの鮮度管理も重要なポイントの一つです。
13. 求人数が多い場合は求人フィードの自動生成が重要
ここまで見てきたとおり、スタンバイの求人フィードは、求人DBの情報をそのまま出力すれば完成するものではなく、元データを媒体仕様に合わせて変換・整形する作業が必要です。そして、この負荷は求人数に比例して膨らみます。
そこで有効なのが、元データから各媒体向けのフィードを自動生成する仕組みです。
求人DB / ATS → データフィード生成・変換 → 媒体ごとの仕様に整形 → スタンバイ用XML + Indeed向けデータ + 求人ボックス向けデータ + その他求人媒体
一度このルールを設計しておけば、スタンバイ用のデータ作成はもちろん、複数媒体への展開も自動で回すことが可能です。求人データフィード運用で難しいのはXMLを書くことそのものではなく、自社の求人データを各媒体が理解できるデータ構造へ継続的に変換する仕組みを作れるかどうかが重要です。
まとめ
スタンバイのXMLフィードでは、求人情報を項目ごとに構造化して連携します。単に求人ページの情報をXMLへコピーするのではなく、「1求人=1職種×1勤務地×1雇用形態」という求人単位や、給与・勤務地・雇用形態などの媒体仕様に合わせてデータを整えることが重要です。
特に、給与を機械が解析できる形式で書く、雇用形態を規定値に変換する、複数勤務地をレコードに分割する、といった処理は、求人データフィードならではのポイントです。
そして、求人件数が多い場合や、スタンバイ以外の求人媒体にも掲載する場合、媒体ごとに求人情報を手作業で整形するのは現実的ではありません。求人DBやATSなどの元データを一元管理し、各媒体の仕様に合わせて必要な項目の変換・分割・整形を自動化することで、求人情報の更新性と正確性を保ちやすくなります。
※本記事は公開情報およびスタンバイの求人掲載マニュアルをもとに作成しています。スタンバイのXMLフィード仕様、必須項目、各種要件は変更される場合があります。実際の入稿にあたっては、スタンバイ公式の求人掲載マニュアルで最新情報を必ずご確認ください。
メディアストリーム株式会社が提供する「FEED STREAM」は、月額1万円からはじめられるデータフィードサービスです。
今回ご紹介したスタンバイのデータフィード作成も簡単な操作で実現できます。
専任スタッフが個別の相談やデータフィードの診断も無料で対応いたしますので、お気軽にお問い合わせください!